
开源仓库
共 9 个仓库 · 按最近更新排序
 Donchitos/Claude-Code-Game-Studios
Turn Claude Code into a full game dev studio — 49 AI agents, 72 workflow skills, and a complete coordination system mirroring real studio hierarchy.
 vuejs/core
🖖 Vue.js is a progressive, incrementally-adoptable JavaScript framework for building UI on the web.
 twbs/bootstrap
The most popular HTML, CSS, and JavaScript framework for developing responsive, mobile first projects on the web.
 DIYgod/RSSHub
🧡 Everything is RSSible
 tailwindlabs/tailwindcss
A utility-first CSS framework for rapid UI development.
 Minglink/dsh-infinite-gen-5
DeepSeek v4.1 flash 逆向工具(无限五代) 求 Star 收藏 ⭐欢迎大家提交项目的改进
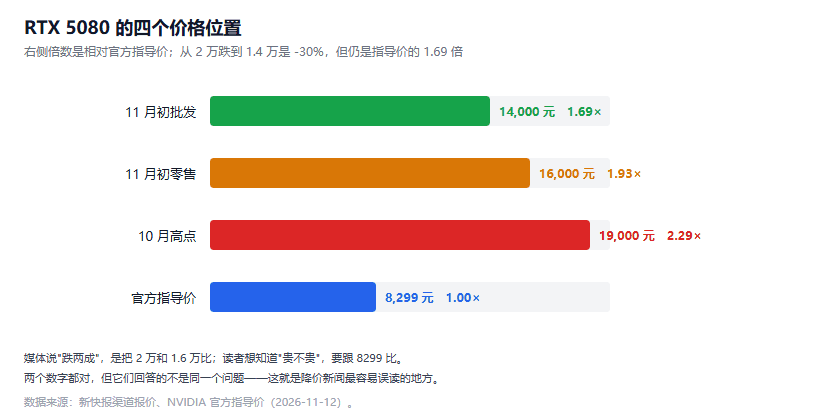
显卡跳水的新闻:三个数字各说各话
一句话总结:同一张RTX5080,报道里能写出"半个月跌两成""较高点降4000元""回到涨价前的区间"三种说法,而它的官方指导价是8299元,现在的1.4万仍是指导价的1.69倍。哪个数字对,取决于你想回答什么问题。我连续看了三天显卡降价的报道,越看越觉得这类新闻有个结构性毛病:它给的是变化...
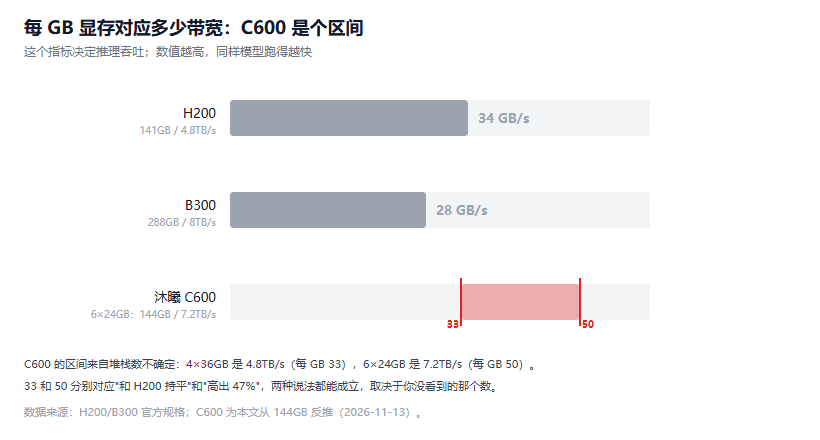
144GB 显存反推:沐曦 C600 的带宽推不出来
一句话总结:沐曦曦云C600标144GBHBM3e。这个容量有4×36GB和6×24GB两种标准拆法,对应的带宽是4.8和7.2TB/s,差50%。规格表只给容量不给堆栈数,所以从公开信息推不出它的带宽。这个数字值得反推,因为"144GB"是个非常规容量。主流配置是80GB、141GB...
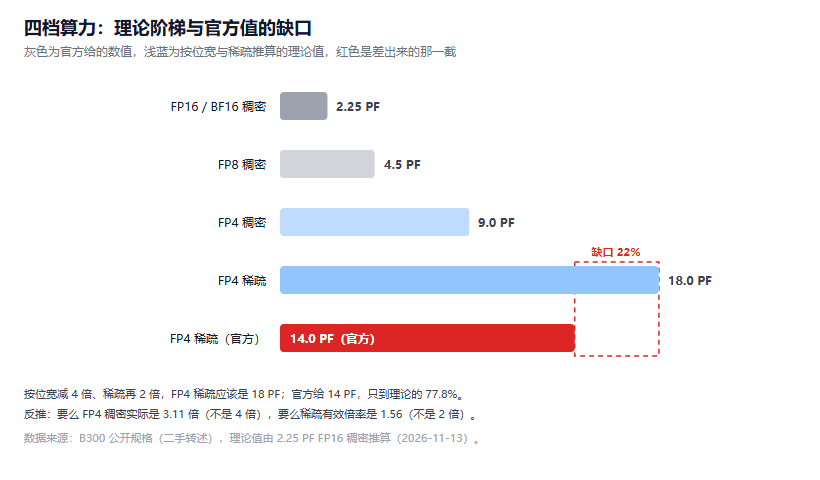
从 14 PFLOPS 反推:FP4 的 6.2 倍差在哪
一句话总结:B300的规格里同时给了FP16稠密2.25PFLOPS和FP4稀疏14PFLOPS,两者相差6.22倍。理论倍数应该是8倍(位宽减4倍×稀疏2倍)。差的22%说明至少有一档的口径和标称不一样。这类规格表最容易被误读的地方,就是拿两个峰值直接相除,得出"性能...
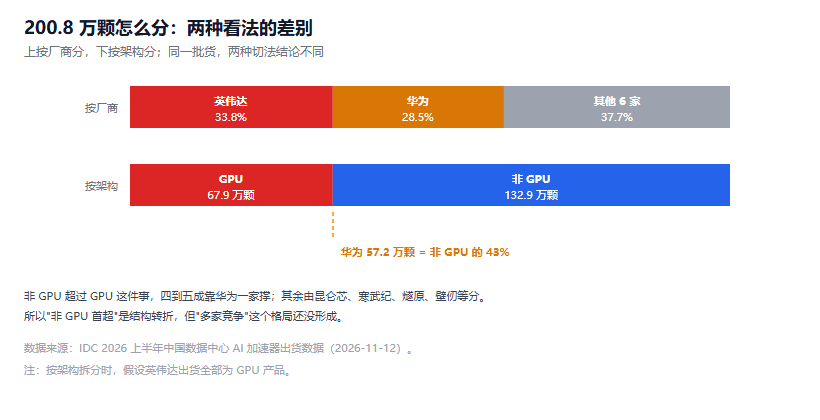
200.8 万颗 AI 加速器:份额怎么拆
一句话总结:2026上半年中国数据中心AI加速器出货200.8万颗,英伟达33.8%、华为28.5%,非GPU首次超过GPU。但把"非GPU过半"这个转折拆开看,它主要靠华为一家撑——华为占非GPU的47%到57%。这个数字我先看到的是"非GPU首超GPU",觉得是个结构性...
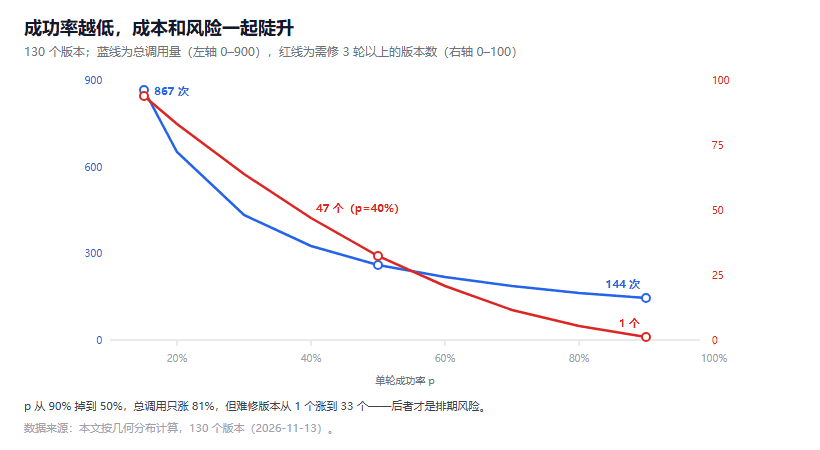
130 个版本要多少次 agent 调用:算给你看
一句话总结:SII那套预训练RSI里,agent要收敛130多个基础设施版本。按几何分布算,单轮成功率70%时总调用186次,其中12个版本要修3轮以上;成功率掉到50%,总调用涨到260次,难修的版本变成33个。这个估算的价值不在于算出准确数字,在于看清成本结构:RSI的...
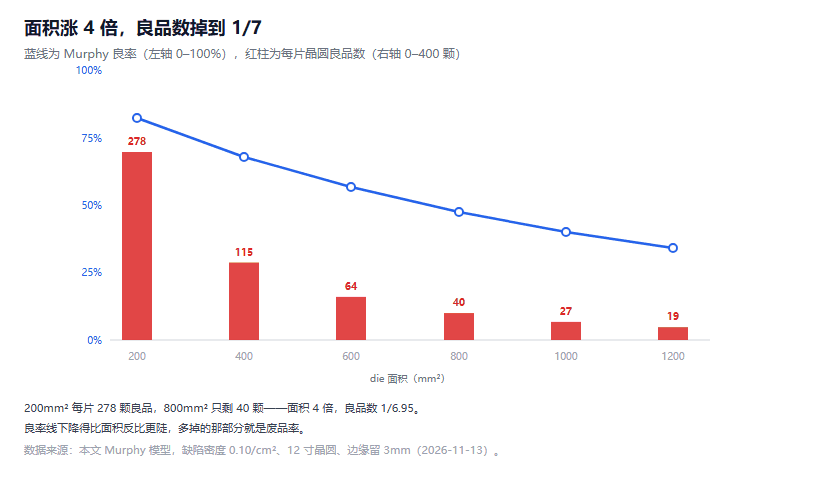
封装面积翻 4 倍,良品数掉到 1/7:算一遍
一句话总结:AI芯片的单颗封装面积是传统芯片的2–4倍。用Murphy良率模型算,面积从200mm²涨到800mm²,每片晶圆的良品数从278颗掉到40颗——面积涨4倍,良品数掉到1/7。这个数字解释了为什么先进封装产能是这轮AI硬件的真瓶颈。不是"造不出来",是"造出来的废品...
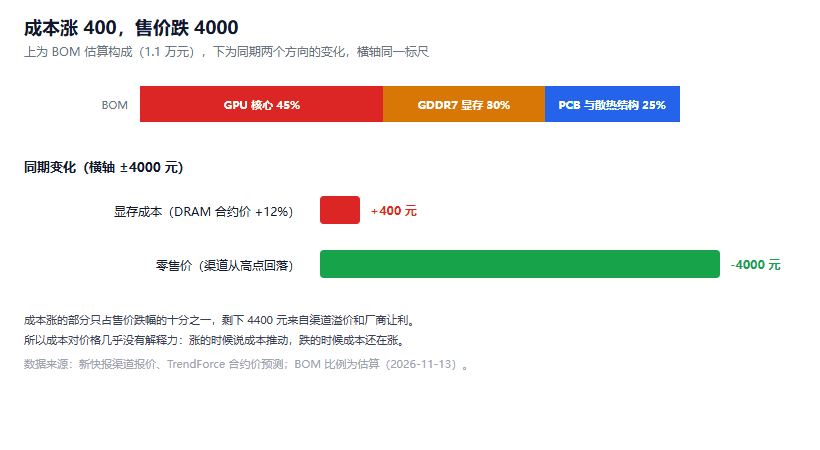
显卡跌 4000 元,DRAM 涨 15%:传导断了
一句话总结:RTX5080从10月下旬的近2万跌到1.6万,广州批发渠道已经报到1.4万;同一个月,集邦咨询预计第四季度一般型DRAM合约价环比涨10%–15%。显卡和内存本该同向,现在反着走。这两条消息我是在同一天看到的,第一反应是"哪个数据错了"。显卡的成本里显存占大头,内存涨价,...
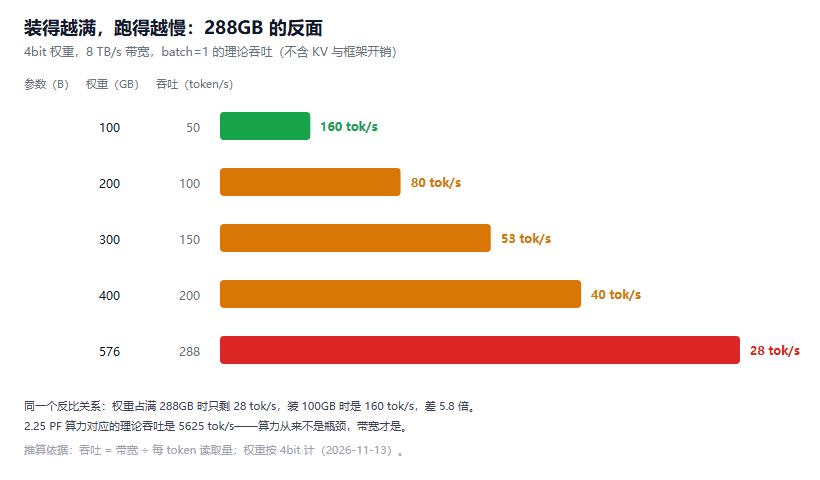
B300 的 288GB 显存:单卡能装下多大模型
一句话总结:B300单卡288GBHBM3e、8TB/s带宽、2.25PFLOPSFP16稠密算力。288GB意味着4bit下能装576B参数,听起来"单卡跑大模型"成立了。但按带宽算,装得下不等于跑得动——200B模型单卡batch=1只有80token/s。先把三个数字的关系...
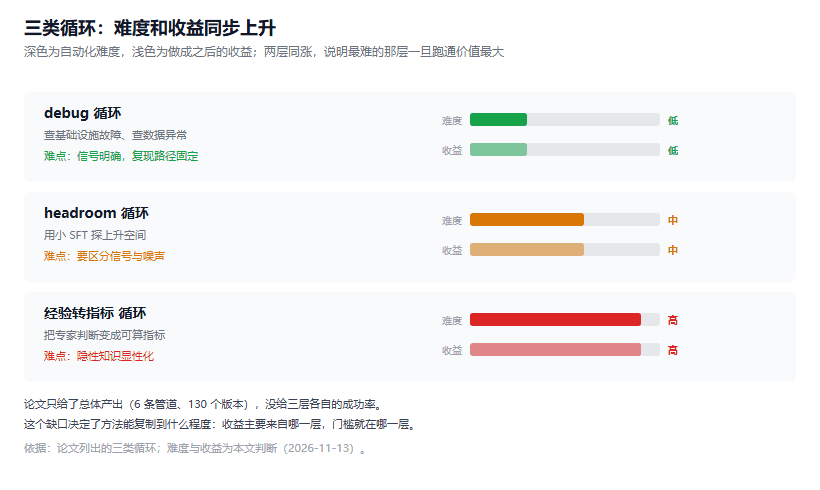
RSI 用到预训练上:6 条管道,130 个版本
一句话总结:上海AI实验室(SII)和心绪AI把递归自我改进(RSI)从后训练搬到了预训练,agent不是改模型,是改"造模型的流程"——6条数据管道、130多个基础设施版本。产出的801-30B-A3B只用6Btoken做SFT、没做RL,四个agentic基准平均分超过了全后训练...
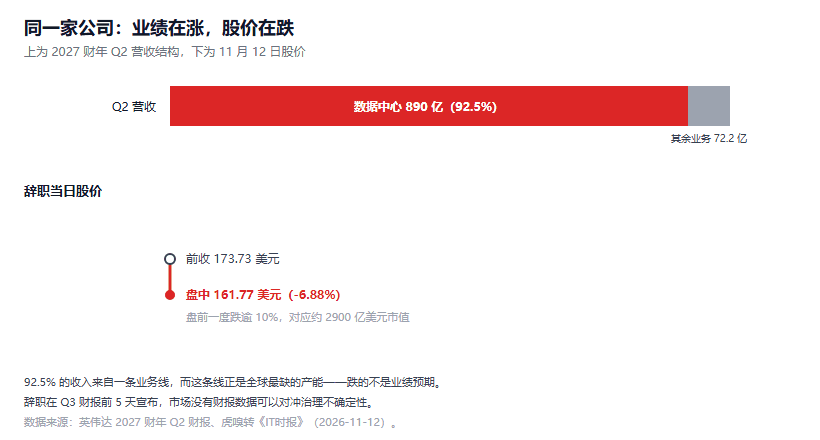
黄仁勋为什么辞职:33 年后交棒,股价跌 6.9%
一句话总结:11月12日英伟达董事会宣布黄仁勋辞去总裁、CEO及董事职务,即刻生效,CFO克雷斯出任临时CEO。当天股价从173.73美元跌到161.77美元,跌6.88%,但公司上一季营收同比还在涨106%。先把事实摆清楚,因为这个消息的每个细节都容易被过度解读。辞职是"即刻生效",没...